
上一篇已經把每日巡檢的需求整理完。
維運人員每天早上主動執行 Skill,系統檢查從上一份報告到現在的完整期間,最後產生一份可以直接閱讀的巡檢報告。整個過程只會查詢資料,不會修改 Kubernetes 資源。
今天先根據這些已經決定的需求,把架構與執行流程畫出來。
先用簡單的流程來看,整個架構可以先簡化成這條主線:
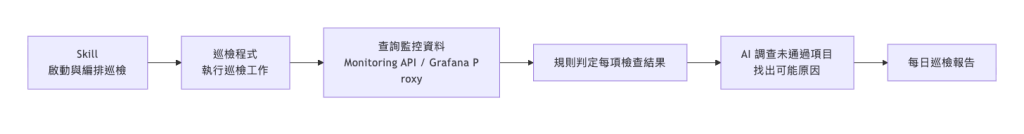
Skill 負責啟動與編排,巡檢程式負責取得監控資料,再用固定規則判定狀態。AI 只會收到未通過的項目,完成調查後再產生最後的報告。
接下來先討論核心的工具:巡檢程式。
巡檢程式第一個要處理的問題,就是去哪裡查監控資料。
前一篇提過兩種做法。第一種是直接呼叫 Prometheus API 與 Loki API;第二種是統一連到 Grafana,再透過 Grafana Data Source Proxy 轉送查詢。
如果 Prometheus、Loki 與其他監控資料都已經接上 Grafana,程式可以只連到 Grafana,再依照不同的 Data Source UID 查詢資料。環境裡有多套 Prometheus,卻沒有透過 Thanos 集中管理時,也可以用這種方式選擇不同的 Data Source。
這個做法會讓 Grafana 成為巡檢程式的共同查詢入口。只要 Grafana 發生問題,即使後面的 Prometheus 與 Loki 還活著,巡檢程式仍然會查不到資料。
我這次選擇直接呼叫 Prometheus API 與 Loki API。實驗環境只有一套主要資料來源,直接查詢比較單純,也少經過一層服務。之後遇到多叢集或多套 Data Source,再依照環境調整查詢方式。
Prometheus 負責提供 metrics,Loki 則保留 logs 與 Kubernetes Event。固定巡檢時,Kubernetes Warning Event 會直接透過 LogQL 查詢,再交給固定規則判定。進入 AI 調查後,Loki 裡的 logs 與 Event 還可以用來補查異常原因。需要確認資源目前的狀態時,再透過唯讀 Kubernetes API 查詢。
要把巡檢項目轉成可查詢的資料需求,我先把每個問題拆成三個部分:
查詢對象
是整個叢集、每一台 Node,還是每個 namespace、Pod、Container 或 PVC。
查詢時段
每日巡檢要涵蓋從上一份報告到現在的完整期間。只看最後幾分鐘,很容易漏掉半夜發生、早上已經恢復的問題。
查詢內容
查詢內容要先確認哪些 metrics 可以回答巡檢問題,以及這些 metrics 實際代表什麼。
例如 Node 是否正常,可以觀察 Node Ready 狀態;資源使用情況可以查看 CPU、Memory 與磁碟使用率;Container 在巡檢期間是否曾經重啟,可以查看 restart counter;Container 是否正常執行,還要搭配 waiting reason、OOMKilled 與 Workload 就緒副本等資訊一起確認。
Control Plane 要先確認 apiserver、kube-controller-manager、kube-scheduler 與 etcd 等核心服務是否持續正常。接著再查 apiserver 5xx、etcd leader 與 etcd proposal failure,確認巡檢期間是否曾經出現請求錯誤或無法完成寫入。
Prometheus 裡保存的是 time series,每條資料都有一連串時間與數值。巡檢程式不會先把整段原始資料全部拉回來再慢慢整理,每個巡檢項目的 PromQL 會先定義要怎麼收斂這段資料。
例如 Node Ready 透過 min_over_time 取出巡檢期間的最低值,Container restart 則使用 increase 計算這段期間累計增加多少次。巡檢程式在期間結束時執行這些 query,拿到每個查詢對象整理後的數值,接著再套用門檻。
每種 metrics 關注的數值都不一樣,常見的情況可以整理成以下幾類:
| Metrics 類型 | 整理方式 | 例子 |
|---|---|---|
| 狀態 | 查詢期間內的最差狀態 | Node 是否曾經 NotReady |
| 使用率 | 找出巡檢期間的最高值與對應資源 | CPU、Memory、PV 使用率 |
| 累計次數 | 計算巡檢期間內增加多少次 | Container restart、apiserver 5xx |
| 資料蒐集狀況 | 確認應該收到資料的對象是否都有回傳資料 | 4 個 Prometheus Target 中有 3 個持續回傳資料 |
| 趨勢 | 比較期間開始值、結束值與變化速度 | 磁碟與 PV 剩餘空間 |
例如 CPU 使用率關心的是巡檢期間有沒有飆高,因此會保留最高值。Container restart 已經是累加的 counter,這時要看期間內增加多少次。Node Ready 則要確認巡檢期間是否出現 NotReady,只需保留期間內的最差狀態。
整理結果要保留巡檢期間、查詢對象、數值、單位與 query,方便日後回查來源。CPU、Memory 這類平常就應該有數值的資料,查不到時會標記為資料不足。Container restart、OOMKilled 這類只有發生問題才會出現的資料,沒有查到就代表這段時間沒有發生。
metrics 整理完成後,接著用固定規則判斷每個巡檢項目。
這次將 Node CPU 使用率 80% 設為警告門檻,95% 設為失敗門檻。產生報告時,CPU 仍超過 80% 會判定為 WARN,仍超過 95% 會判定為 FAIL。如果 CPU 在巡檢期間最高到 96%,產生報告時已經恢復,結果會降為 WARN。
報告會另外顯示超過門檻的時間,方便維運人員判斷這次是短暫尖峰,還是持續性的資源壓力。Node 曾經 NotReady 會判定為 FAIL;缺少判斷資料則標記為 UNKNOWN。
判定結果由固定規則產生,AI 只負責調查 WARN、FAIL 與 UNKNOWN。
固定規則完成判定後,AI 會調查 WARN、FAIL 與 UNKNOWN,根據 metrics、logs 與 Kubernetes Event 找出可能原因。AI 只能補充調查結果,不能修改原本的判定。
最後將所有巡檢項目與調查結果整理成報告,交由維運人員確認並決定後續處理方式。
這次把每日巡檢拆成資料查詢、metrics 整理、規則判定、AI 調查與報告產出。固定規則負責產生一致的判定,AI 則集中調查未通過與資料不足的項目。
架構決定後,下一篇就開始實作,看看巡檢項目如何執行,最後又怎麼產生每日報告。
今天就先寫到這,我們明天見!


 iThome鐵人賽
 看影片追技術